
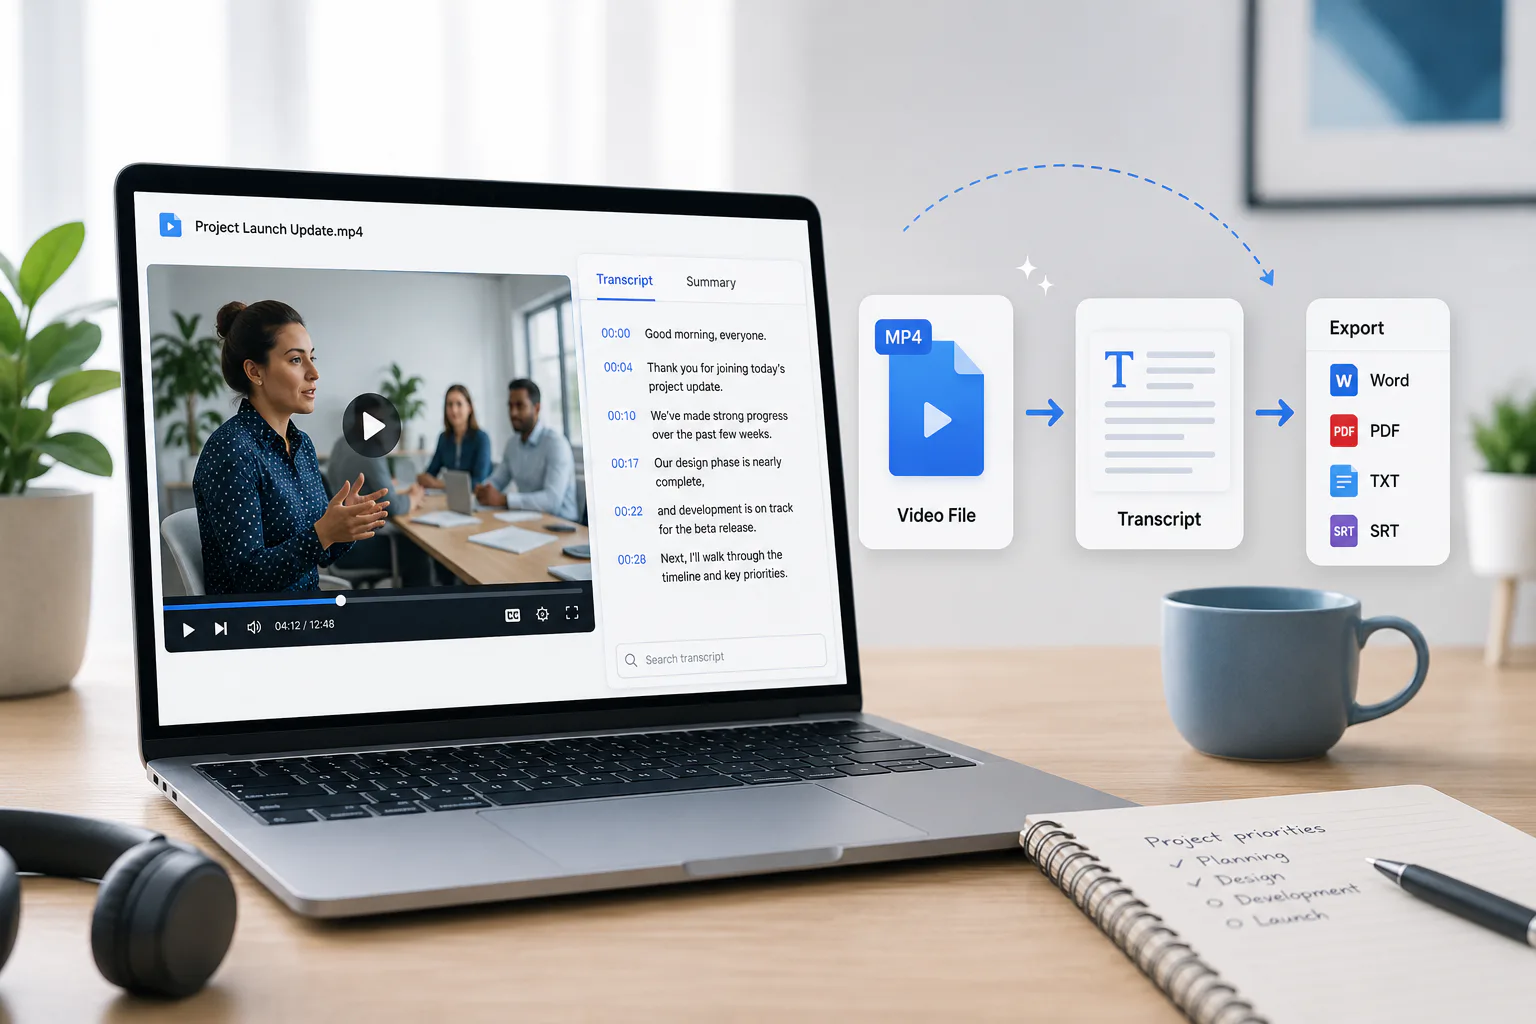
将 MP4 上传到 TranscribeNext,系统会读取音轨,无需先转为 MP3。在本页历史样本中,30–60 分钟 MP4 的任务完成耗时中位数为 3.8 分钟。可先试用前 5 分钟预览,完整处理和说话人识别按套餐开放。
转写指南 · 更新于 2026 年 7 月 · 约 9 分钟阅读
MP4 转文字:把视频整理成文字稿
上传 MP4,获取可编辑文本和时间信息。下方指南介绍实际处理流程,并结合 5,266 个历史样本说明耗时和文件大小。
Free
免费预览提供前 5 分钟内容,无需银行卡。游客额度以页面提示为准,登录和升级后可使用相应的完整处理及导出功能。
简要方法:上传 MP4,确认录音语言,等待识别,再校对并按套餐导出 TXT、DOCX、PDF、SRT、VTT 或 JSON。通常无需先转换或提取音轨;如果视频很大、网络较慢,单独导出音频可把上传量从 GB 降到 MB。
说明:TranscribeNext 是我们提供的服务。本页数据来自我们的生产环境样本,并列出样本量,便于判断适用范围。文中也介绍 YouTube 字幕、Microsoft Word 和离线 Whisper 等其他方式。
MP4 里面是什么,转写处理哪一部分?
MP4 是容器,通常包含独立的视频轨道(如 H.264 或 HEVC)和音频轨道(如 AAC)。转写读取音轨,画面不会进入语音识别模型。
因此,2 GB 视频与仅 40 MB 的音频可能得到相近文本;先转成 MP3 并不会自动提高准确率。同一次对话,录音条件比扩展名更重要。
下面是上传样本中,每分钟录音对应的文件体积中位数:
| 容器 | 每分钟体积中位数 | 相对 M4A | 样本数 |
|---|---|---|---|
| MOV (.mov) | 33.9 MB | 56× | 987 |
| MP4 (.mp4) | 5.4 MB | 9× | 4,550 |
| WAV (.wav) | 1.8 MB | 3× | 1,187 |
| MP3 (.mp3) | 0.92 MB | 1.5× | 10,586 |
| M4A (.m4a) | 0.61 MB | 1 倍(基准) | 8,481 |
在这些样本中,MP4 每分钟体积约为 M4A 的九倍。MP4 体积中位数为 84 MB,时长约 18 分钟;最大的 5% 超过 1.3 GB,已处理最大样本为 4.9 GB。大量数据来自画面,而非转写需要的声音。不同文件并非一一对应,比例仅作参考。
该数据集包含 5,266 个 MP4,占总量 14.7%,常见于会议、手机录像和录屏。技术限制见MP4 转写格式说明,其他来源见支持的音视频格式。
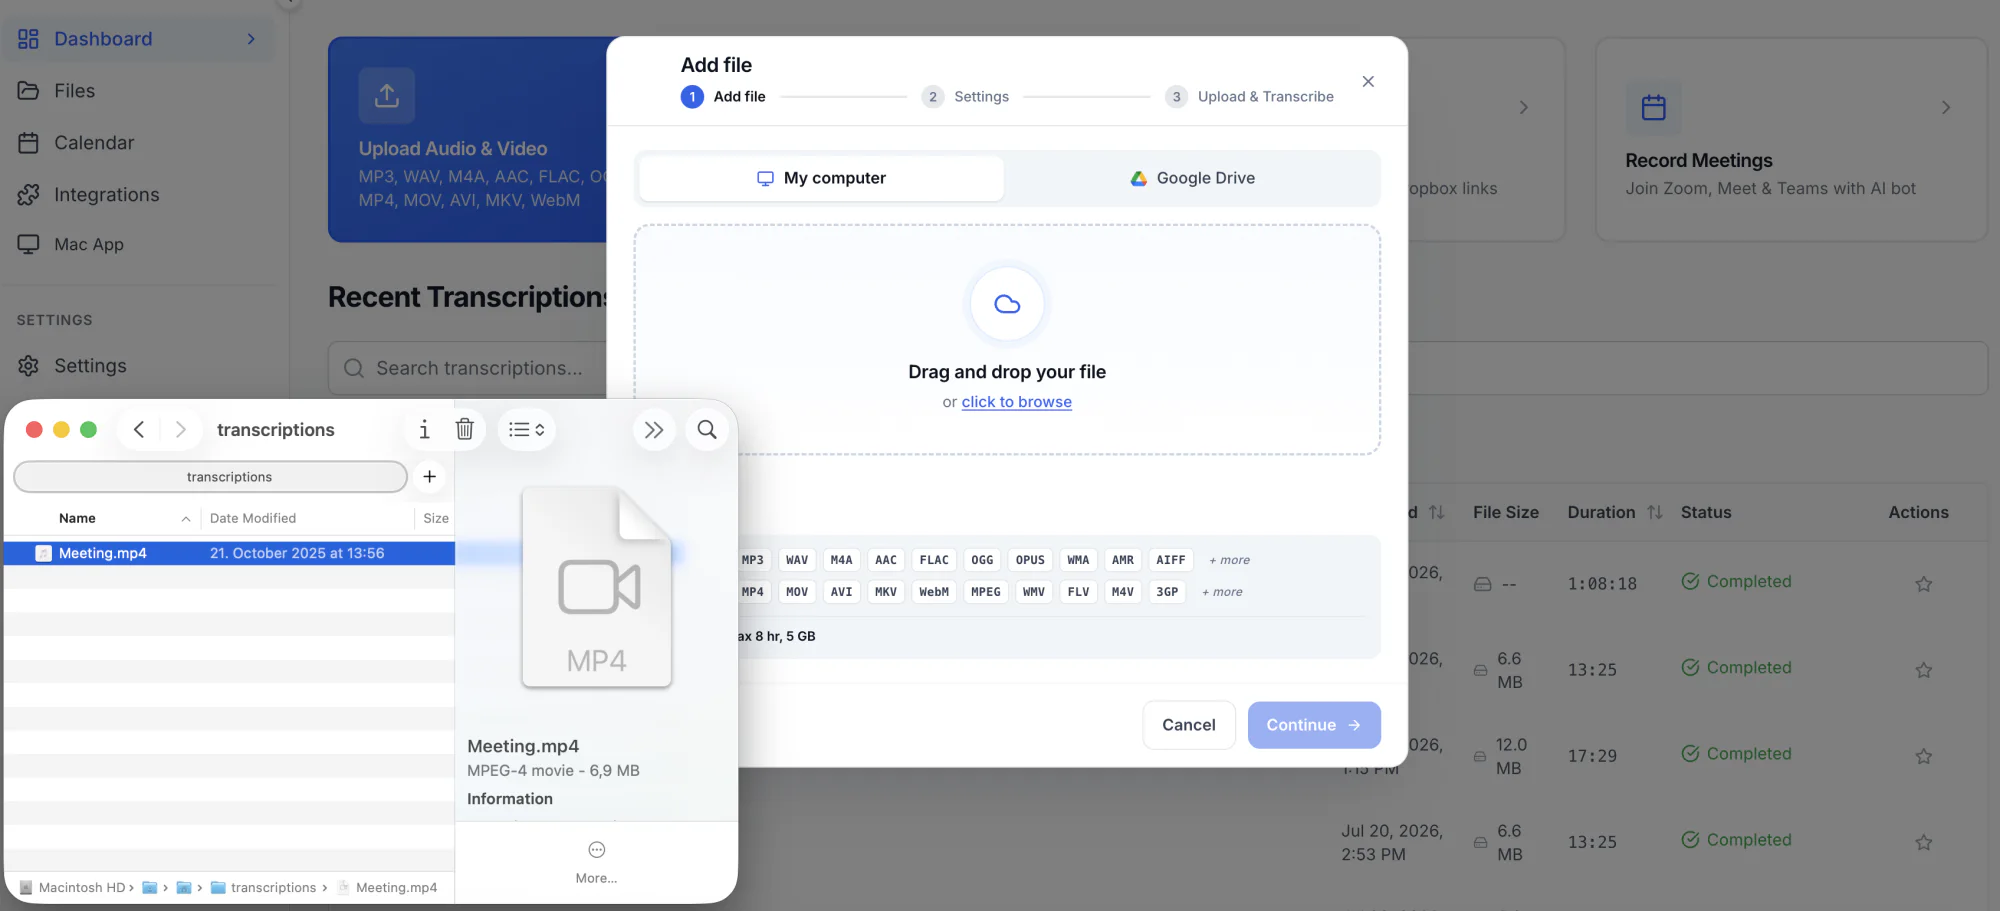
五步把 MP4 转为文字
上传原文件,确认语言,等待音轨处理,再校对和导出。
- 优先使用原始 MP4。避免不必要的有损重新编码或经聊天应用反复压缩。保留录制设备导出的原件。
- 上传文件。将 MP4 放入本页上传区域,系统自动读取音轨。MOV、MKV、WebM、AVI、M4V 等受支持格式也可直接处理。
- 确认语言。已知录音语言时可手动指定,尤其是开头有静音、音乐或多语言混杂的内容。
- 对照音频校对。重点检查姓名、数字、缩写、引文和重叠讲话片段,不能只看句子是否通顺。
- 校正说话人并导出。DOCX 适合继续编辑,PDF 适合分享,TXT 适合纯文本,SRT/VTT 适合字幕,JSON 适合结构化处理。可用格式取决于套餐。
转写 MP4 实际需要多久?
以下来自已完成 MP4 任务的历史记录,列出中位数及第 90 百分位。样本覆盖从任务记录创建到结果更新的过程,不应把它当作固定时限或当前单次任务的保证。
| MP4 时长 | 耗时中位数 | 90% 的任务在此时间内完成 | 相对实时速度 | 样本数 |
|---|---|---|---|---|
| 少于 10 分钟 | 42 秒 | 5.6 分钟 | 4.7× | 1,641 |
| 10–30 分钟 | 1.8 分钟 | 20.4 分钟 | 9.9× | 1,278 |
| 30–60 分钟 | 3.8 分钟 | 25.1 分钟 | 11.8× | 902 |
| 超过 60 分钟 | 5.4 分钟 | 32.4 分钟 | 18.3× | 632 |
长文件在样本中相对录音时长的处理速度更高,因为启动和排队等固定开销在短片中占比更大。中位数与第 90 百分位差距较大,说明等待时间会波动。大文件的本地网络上传还可能成为额外瓶颈;仅凭这些汇总数据,不能将所有慢任务归因于某一个阶段。
需要先提取 MP4 的音频吗?
通常不需要。但视频很大且上传较慢时,单独提取音轨很有帮助。
如果直接复制原音轨而不重编码,可以去掉画面数据而不改变声音。上述不同格式样本的中位体积差异约为 89%,具体一个文件能缩小多少取决于内部码率。
使用 FFmpeg,对于可放入 M4A 的音轨,可这样复制:
ffmpeg -i recording.mp4 -vn -acodec copy recording.m4a-vn 不输出视频,-acodec copy 保留原音频编码。详情可看M4A 转文字指南。除非后续工具需要 MP3,否则不必改用 -acodec libmp3lame 再次有损编码。请保留原文件。
什么决定 MP4 转写准确率?
没有说明测试音频和参考文本的“98%”或“99.9%”不能直接用于预测您的文件。常见指标为词错误率(WER),比较参考文本中的替换、遗漏和新增词。中文评估还需统一分词规则,也常使用字错误率。
主要影响因素包括:
- 重叠讲话。多人同时说话容易丢失内容和分错说话人。
- 麦克风距离。远处笔记本麦克风可能录入更多回声,近距离收音更有帮助。
- 背景噪声。空调、交通、咖啡馆和键盘声均可能影响识别,突发噪声尤其难处理。
- 口音与专业词汇。姓名、药名、法律引用、证券代码和内部术语需要重点核对。
- 音频码率。部分录屏或会议工具使用较低码率,录制时丢失的细节无法靠之后提高码率恢复。
- 容器和编码。同一清晰音轨换容器通常不会提高准确率,避免不必要的有损转换。
近距离、清晰的一两人对话通常更容易校对;嘈杂环境中的多人会议可能需要较多编辑。纯音频处理也可参考音频转文字指南,了解 MP3、WAV、M4A 及 Word、离线 Whisper 等方法。
MP4 转文字可以免费吗?
“免费”可能指不同限制,使用前应确认:
- 按分钟计的试用。用完赠送额度后需付费。
- 文件预览。TranscribeNext 提供前 5 分钟预览,方便先用自己的录音检查效果。游客使用仍受页面显示的额度和文件限制约束。
- 长期免费但功能受限。可能限制时长、导出或说话人识别,数据处理方式应查看服务条款,不能仅凭“免费”判断。
- 在本机运行 Whisper。软件可用于本地处理,但需要自行安装、下载模型并提供相应硬件。敏感数据仍应遵守组织规定。
不同 MP4 转写方法对比
| 方式 | 适用场景 | 说话人标签 | 主要限制 |
|---|---|---|---|
| AI 转写服务 | 会议、采访、讲座、播客和课程视频 | 支持 | 需要校对;超出免费范围后需付费 |
| YouTube 自动字幕 | 原本就准备上传平台的视频 | 不提供 | 需上传到平台;不自动标注说话人,导出流程不同 |
| Microsoft Word 转录 | 已使用 Word 的 Microsoft 365 用户 | 基础支持 | 有用量限制;音频保存在 OneDrive |
| 离线 Whisper | 需要本地处理的录音 | 需另行配置 | 需安装和下载模型;速度取决于硬件 |
| 人工转写服务 | 出版、法律材料和专业术语较多的内容 | 支持 | 通常按时长收费,交付可能需数小时至数天 |
| 手动转写 | 极短或特别敏感的片段 | 支持 | 一小时录音可能需要 3–6 小时整理 |
说话人标签:区分谁说了什么
说话人识别将对话分成不同发言片段,并添加标签,让会议文本更容易阅读。
在启用该功能的 MP4 样本中,两位说话人最常见,其次是三位和一位。人数越多、打断越频繁,自动分配越容易出错。
标签通常显示为“说话人 1”“说话人 2”等,可修改名称。编辑器也支持调整片段归属。请使用其规定的说话人标记格式,并在保存后确认结果;自动识别需要相应付费套餐。
识别语言
支持 100 多种语言。本页统计样本中,英语约占已识别 MP4 语言的 83%,还包括西班牙语、法语、中文、俄语、韩语、葡萄牙语、阿拉伯语、希伯来语和日语。
开头的音乐或静音可能干扰自动检测,已知语言时可手动选择。同一句话内频繁切换语言更容易出错,需要重点校对切换位置。
如何选择导出格式?
根据后续用途选择:
- TXT:纯文本,适合搜索、复制和交给其他工具处理。
- DOCX:适合在 Word 或 Google Docs 中继续编辑。
- PDF:适合发送固定版式文档或归档。
- SRT、VTT:用于字幕,需要有效且与正文匹配的时间信息。上传 YouTube 前可阅读人工校对字幕与自动字幕的区别。
- JSON:提供实际可用的时间、说话人和片段等结构化数据,方便其他程序处理。
隐私:上传视频前检查什么?
客户通话、医疗咨询或内部会议等敏感材料,上传前应确认:内容是否用于训练、保留多久、能否删除,以及哪些外部服务商会参与处理。详情请看当前隐私政策。如果组织不允许数据离开本地环境,应使用获批准的本地工具,而不是假设某个云端套餐能改变该要求。
让 MP4 转写更准确的建议
- 从录音源头改善音质。让麦克风靠近说话人,比事后反复转换更有效。
- 尽量轮流讲话。减少重叠声音,方便识别和分配说话人。
- 使用原文件。避免录屏播放中的视频,或使用反复压缩的聊天副本。
- 清晰说出姓名和术语。也可在上传设置中提供正确写法作为上下文。
- 对照音频,不只看语句是否合理。AI 可能生成通顺但错误的句子。